La expansión de la inteligencia artificial convirtió el gobierno de la información en una decisión estratégica. Regulación, ciberseguridad, infraestructura y soberanía de los datos comienzan a ocupar un lugar central en la agenda empresarial.
La expansión de la inteligencia artificial está obligando a las empresas a revisar un asunto que durante años permaneció principalmente en manos de tecnología: quién controla los datos, dónde se almacenan, bajo qué jurisdicción circulan y qué tan confiables son para alimentar los nuevos sistemas de IA.
El debate ya no es únicamente técnico. La presión regulatoria, los riesgos de ciberseguridad y las tensiones geopolíticas han elevado la soberanía de los datos a un asunto de gobierno corporativo. Un estudio global de 2026 citado en el documento señala que el 76% de las organizaciones espera que este tema gane importancia, mientras los requisitos legales aparecen como el principal factor externo que impulsa esa preocupación.
El problema se agrava cuando una compañía maneja varias copias de la misma información en distintos entornos, sin claridad sobre cuál es la versión vigente, quién puede acceder a ella o qué regulación aplica. Los riesgos alcanzan el cumplimiento, la seguridad y la operación.
La IA añade presión. Estos sistemas procesan grandes volúmenes de información y dependen de datos limpios, actualizados y correctamente clasificados. Cuando la información está duplicada o mal gobernada, las respuestas pueden perder precisión o exponer contenidos restringidos. El documento advierte que la precisión y la confianza en resultados generados por IA todavía rondan el 40%.
La infraestructura también aparece como una barrera. El 59% de las organizaciones dispone de una infraestructura que limita la efectividad de la IA. Muchas plataformas fueron diseñadas para sistemas tradicionales y no para las actuales exigencias de trazabilidad, seguridad y control.
El reto aumenta cuando los datos están distribuidos entre proveedores de nube, hyperscalers y aplicaciones SaaS. Esa dispersión puede dificultar saber dónde reside la información e incluso si atraviesa una jurisdicción diferente.
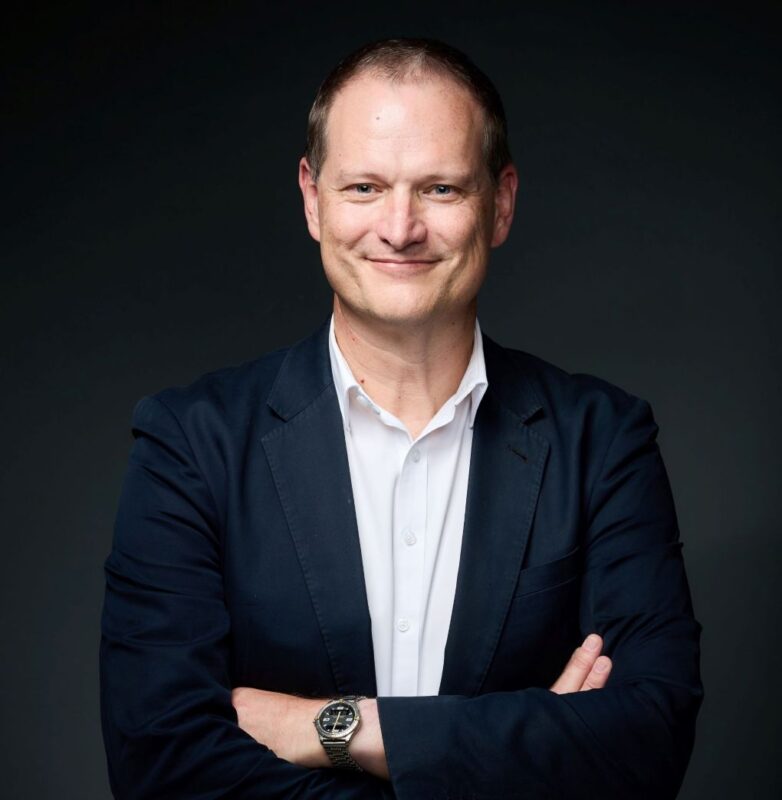
Para Adrian Johnson, Chief Revenue Officer de Hitachi Vantara, el punto de partida es comprender qué regulaciones aplican a cada tipo de dato, cómo está clasificado y quién puede utilizarlo. La discusión no consiste en frenar la IA, sino en construir una base de gobierno e infraestructura que permita avanzar sin perder control.
En la práctica, esto implica reducir silos, unificar la visibilidad sobre los entornos de almacenamiento y establecer reglas claras de acceso, conservación y uso. Las organizaciones que sepan dónde están sus datos, cómo están gobernados y qué infraestructura los soporta estarán mejor preparadas para gestionar los riesgos y convertir la inteligencia artificial en resultados confiables.